Mac mini vs Mac Studio 比較2026|64GB同士の差は66,000円
「Mac miniは149,800円から、Mac Studioは419,800円から。3倍近く違うならMac miniでいいかな」
2026年8月25日の発表を見て、そう思った人は多いはずです。私も最初はそう考えていました。
しかし、AI開発でローカルLLMを動かす前提で構成を詰めていくと、この前提は崩れます。同じ64GBメモリ・1TBストレージに揃えたとき、2機種の価格差は66,000円しかありませんでした。
私は発表当日、Mac Studio(M5 Max / 64GB / 1TB)を653,800円で予約注文しました。現用機はMacBook Pro M1 Max 32GBです。この記事では、注文画面で実際に構成を組んだ比較結果と、M6搭載Mac miniやM5 Ultraを外していった過程をそのまま公開します。
この記事を読むと、次の3つが分かります。
- 💰 同一構成に揃えたときの実価格(最小構成同士の比較は判断材料になりません)
- 📊 その66,000円で何が2倍になるのか(メモリ帯域とGPUコアが揃って2.00倍です)
- 🔍 ネット上のベンチマーク数値を検算する方法(実際に、計算が合わない数値を2つ見つけます)
結論を先に言うと、AI用途で64GBを積むなら、迷わずMac Studio M5 Maxです。ただし「そもそも買わなくていい人」もいるので、そこも含めて説明します。
💡 【結論】2026年新型を64GBで比較するとMac Studio M5 Max|差額66,000円
AI開発・ローカルLLM用途でメモリ64GBを積むなら、Mac Studio M5 Max(40コアGPU)を選ぶべきです。
理由は単純で、同じ構成に揃えると価格差が66,000円まで縮むのに、その66,000円でメモリ帯域とGPUコア数が揃って2.00倍になるからです。
「Mac miniのほうが27万円安い」という印象は、最小構成同士を比べたときにだけ成り立つ話でした。
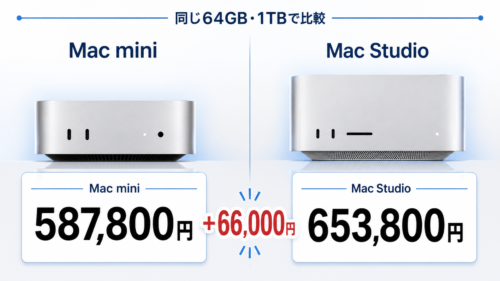
💴 同じ64GB・1TBに揃えると、価格差は66,000円しかない
先に前提をひとつ。冒頭に出した149,800円のMac miniは「M6版」で、この比較表の299,800円は「M5 Pro版」です。 同じMac miniという名前ですが中身は別モデルで、64GBのメモリを積めるのはM5 Pro版だけです。だからAI用途の比較対象は、最初からM5 Pro版になります(M6版を外した理由は次の章で書きます)。
実際にApple公式ストアでMac miniの構成とMac Studioの構成を組んだ結果がこちらです。
| 項目 | Mac mini M5 Pro | Mac Studio M5 Max |
|---|---|---|
| CPU | 18コア | 18コア |
| GPU | 20コア | 40コア |
| Neural Engine | 16コア | 16コア |
| メモリ | 64GB | 64GB |
| ストレージ | 1TB | 1TB |
| 10Gb Ethernet | オプションで追加 | 標準搭載 |
| 合計 | 587,800円 | 653,800円 |
| 差額 | — | +66,000円 |
内訳も注文画面で1ステップずつ確認しました。
- Mac mini: 299,800円(標準)+ 36,000円(18コアCPU/20コアGPU)+ 180,000円(24→64GB)+ 54,000円(512GB→1TB)+ 18,000円(10Gb Ethernet)= 587,800円
- Mac Studio: 419,800円(標準)+ 54,000円(40コアGPU)+ 126,000円(36→64GB)+ 54,000円(512GB→1TB)= 653,800円
Appleのメモリ単価は1GBあたり4,500円、ストレージは512GB→1TBが54,000円で、これは両機種で共通でした(7つの構成で検算して、例外はありませんでした)。
[!warning] ⚠️ この66,000円には条件があります
CPUとGPUのコア数を揃えなければ、差額は66,000円ではありません。
Mac mini M5 Proは、標準の15コアCPU/16コアGPUのままでも64GBを選べます。その構成なら551,800円(10Gb Ethernet込み)で、差は102,000円に広がります。10Gb Ethernetを外して2.5Gbのままにするなら533,800円で、差は120,000円です。
Mac Studioは10Gb Ethernetが標準搭載なので、条件を揃えた比較としては102,000円のほうが正確です。「66,000円」はCPU/GPUの格まで揃えた場合の数字だと理解してください。
⚡ その66,000円で「ちょうど2.00倍」になるもの
66,000円を足すと何が変わるのか。ここがこの比較のいちばん分かりやすいところです。
| 項目 | Mac mini M5 Pro | Mac Studio M5 Max | 差 |
|---|---|---|---|
| メモリ帯域幅 | 307GB/s | 614GB/s | 2.00倍 |
| GPUコア | 20コア | 40コア | 2.00倍 |
| メモリ上限 | 64GBまで | 128GBまで | 注文時のみ選択可 |
※ Apple Siliconのメモリは基板直付けで、後から増設はできません。ここでいう「上限」は注文時点で確定する天井です。
演算資源と帯域が、きれいに揃って倍になります。 ローカルLLMの生成速度はメモリ帯域でほぼ決まるので、この2.00倍は体感に直結します。
なお筐体まわりでは、Mac StudioにUSB-A×2・SDXCカードスロット・Thunderbolt 5×4ポート・外部ディスプレイ最大5台という差がありますが、これはAI性能とは別軸の話です。
ただし、Mac miniが勝っている点も正直に書いておきます。
- 🪶 重量: Mac mini M5 Pro 0.73kg vs Mac Studio 2.7kg(約3.7倍の差)
- 🔌 最大消費電力: Mac mini 155W vs Mac Studio 480W(約3.1倍の差)
- 📦 設置面積: 12.7cm角 vs 19.7cm角
24時間動かしっぱなしのAIエージェント専用機や、机の上を占有したくない用途では、Mac miniのほうが明確に向いています。「速いほうが偉い」わけではありません。
🚫 なぜM6搭載Mac mini(149,800円)を最初に外したのか
新型M6チップは魅力的でした。それでも、ローカルLLM目的なら最初に落選します。
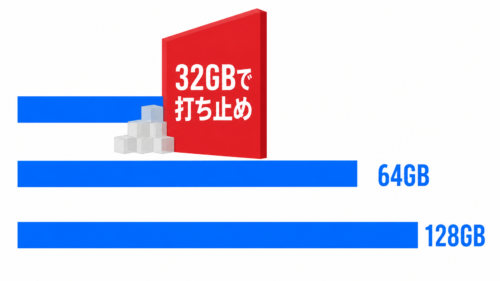
理由はひとつだけ、メモリが最大32GBで打ち止めだからです。
M6は、GPUの全12コアにNeural Acceleratorsを搭載しました。これはMac miniとしては初めてで、AppleはこのGPU側の強化により、M4搭載Mac mini比でAI性能が最大4倍になると説明しています。あわせてApple初のデュアル16コアNeural Engineも積んでおり、こちらは前世代比で最大2倍とされています。チップ単体のAI性能は間違いなく上がっています。
それでも、メモリ上限32GBという一点がすべてを無効化します。
📖 先に用語をふたつだけ
[!note] 💡 「4bit量子化(Q4)」とは
AIモデルの中身は、膨大な数値の集まりです。量子化は、その数値を粗く丸めてファイルを小さくする技術です。元が16bitのところを4bitにすると、容量はざっくり4分の1になります。簡単に言うと、動画の画質を落として容量を減らすのと同じ発想です。多少の精度と引き換えに、そのままでは載らなかったモデルが載るようになります。
ローカルLLMでは4bit(Q4)が事実上の標準で、この記事の数値はすべてQ4前提です。精度を優先した8bit版がQ8で、容量はQ4の約2倍になります。
なお「70B」「8B」のBはパラメータ数10億単位のことで、数が大きいほど賢い代わりに重くなります。
もうひとつ、ユニファイドメモリという仕組みも押さえてください。MacのメモリはCPUとGPUが同じメモリを分け合って使います。Windows PCのようにグラフィックボード側へ専用メモリが載っているのではなく、1つのメモリを共用する形です。
つまり「64GB搭載」でも、その全部をAIモデルの置き場に使えるわけではありません。 macOSが自分用に確保するぶんが必ず引かれます。
🧱 32GB上限が、他のすべての進化を打ち消す
32GB機で実際にGPUが使える枠は、実測報告で21〜25GB程度です(この割合は機種やOSバージョンで変動するので、「一律75%」という説明は正確ではありません)。
一方、70Bクラスのモデルを4bit量子化したファイルは約42.5GBあります。どう転んでも載りません。
つまりM6搭載Mac miniを買っても、今使っているM1 Max 32GBとまったく同じ壁に当たります。乗り換える意味がないので、ここで落選しました。
チップの世代より、メモリ構成のほうが効く場面がある——これが最初の学びでした。
✅ 逆に、M6で十分な用途もある
とはいえ、M6を全否定するつもりはありません。次のような使い方なら、149,800円のM6で十分です。
- 💬 8B〜14Bクラスのモデルを動かす: 4bit量子化なら5〜9GB程度なので、32GBどころか24GBでも余裕があります
- ☁️ クラウドAPI主体のAI駆動開発: Claude CodeやCursorのようなツールは処理をクラウド側が担うため、手元のメモリはほとんど使いません
- 🌙 24時間稼働のAIエージェント常駐サーバー: 最大155W・0.67kg(M6版の重量)という扱いやすさが効きます
なおM6モデルのポートはThunderbolt 4(最大40Gb/s)で、M5 ProのThunderbolt 5(最大120Gb/s)とは別物です(Apple公式のMac mini技術仕様で確認)。外付けSSDにモデルを置いて読み書きする使い方なら、この差は効きます。
実際、私は以前99,800円の最小構成(8GB/256GB)でAI駆動開発が成立するかを10日間検証しています。クラウドAPI主体なら8GBでも動きました。
8GB最小構成でもクラウドAPI主体なら成立した10日間の検証結果
[!tip] 💡 M6を選ぶなら知っておきたい落とし穴
M6は16GB構成のままだと、メモリ帯域が153GB/sに制限されます。 カタログにある「最大170GB/s」は、24GBまたは32GBに増やしたときの値です(Apple公式仕様に明記)。安く済ませようとして最小構成を選ぶと、帯域まで下がります。
📐 ローカルLLMの速度は「帯域 ÷ モデルサイズ」で決まる
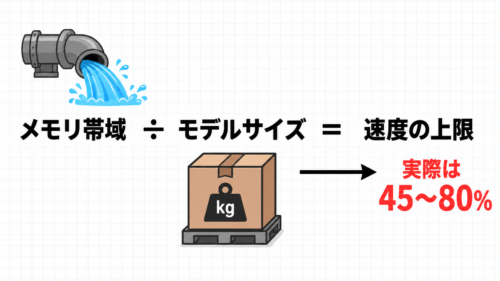
ローカルLLMの生成速度の上限は「メモリ帯域 ÷ モデルの重みサイズ」で決まり、現実に出るのはその43〜80%です。 この割り算ひとつ覚えれば、ネット上のベンチマーク数値が本物かを自分で判定できます。実は小学校の算数レベルで済みます。
🧮 計算式と、現実的な実効率
大規模言語モデルは、1トークン(文字のかたまり)を生成するたびに、モデルの重み全体をメモリから読み出します。だから生成速度の上限は、メモリの読み出し速度=帯域で決まります。
理論上限(tok/s) = メモリ帯域幅(GB/s) ÷ モデルの重みサイズ(GB)ただし、理論値がそのまま出ることはありません。実際に読み出すのは重みだけでなく、会話の履歴を保持するキャッシュや中間データも含まれるからです。
[!important] 📌 この実効率テーブルは公開実測3件からの逆算です
統計的な裏付けはありません。以降の概算値はすべてこの前提に依存します。元データはXiongjieDai/GPU-Benchmarks-on-LLM-Inferenceの Llama-3 70B Q4_K_M(llama.cpp)の実測 tok/s で、重み42.52GBを掛けて帯域と比べた値です。
| 機種 | 理論帯域 | 実測 tok/s | 実効帯域率 |
|---|---|---|---|
| M1 Max | 400GB/s | 4.09 | 約43.5% |
| M2 Ultra | 800GB/s | 12.1 | 約64.3% |
| M3 Max | 400GB/s | 7.5 | 約79.7% |
同じ400GB/sで43.5%と80.0%に割れるのは、測定条件が違うからです。 推論エンジン、OSバージョン、そのとき積んでいた会話履歴の長さで実効率は大きく動きます。つまりこの43〜80%というレンジは「機種の差」ではなく「測り方の差」を含んだ幅です。
私の見立ては中央の65%前後です。以降の概算はレンジで示しますが、期待値としては真ん中を見てください。
📦 量子化とメモリ使用量の対応【概算】
必要メモリは、次の掛け算でほぼ出せます。
必要メモリ(GB) ≒ パラメータ数(B) × 1パラメータあたりのバイト数| 精度 | 1Bあたり | 8B | 14B | 32B | 70B |
|---|---|---|---|---|---|
| FP16(無量子化) | 2.0GB | 16GB | 28GB | 64GB | 140GB |
| Q8 | 1.0GB | 8GB | 14GB | 32GB | 70GB |
| Q4_K_M | 約0.61GB | 4.9GB | 9GB | 20GB | 42.5GB |
Q4_K_Mが0.5GB(=4bit)ちょうどにならないのは、一部の層を6bitで保持するためです(実効4.8bit程度)。「70Bの4bitだから35GB」と概算すると、7.5GBぶん過小に見積もります。
なおこの掛け算はあくまで目安で、実ファイルはモデルごとに前後します(例: 32BクラスのQ4_K_Mは実測19.9GB、70Bクラスは42.52GB)。購入判断に使うときは、動かしたいモデルの実ファイルサイズを配布元で確認してください。
🕵️ ネットのベンチ数値を実際に検算してみる
この式の使いどころは、他人が出した数値の検算です。例をやってみます。
海外の記事に「M4 Max(546GB/s)で70B Q4が22 tok/s出た」という数値がありました。本当でしょうか。
22 tok/s × 42.52GB = 935GB/s の帯域が必要
935 ÷ 546 = 171%帯域の171%が必要という結果になりました。物理的に不可能なので、この22 tok/sは信用できません。
同じ記事群にあった「llama.cppで12.5 tok/s」という、一見おとなしそうな数値も見てみます。
12.5 tok/s × 42.52GB = 531.5GB/s → 546GB/s の 97.3%実効97%——これは物理的に不可能な数値ではありません。 ただし先ほどのレンジ(43〜80%)の上限を大きく超えており、同じ条件で再現された報告は見つけられませんでした。
そして、この検算は「相手もQ4_K_M(42.52GB)で測った」という前提に立っています。相手がMLXの4bit(約39.7GB)で測っていれば分母が変わり、12.5 tok/sは実効86%まで下がります。
だから使い方はこうです。検算に合わない数値を見つけたら「嘘だ」と断じるのではなく、「どの量子化で、どの環境で測ったのか」を確認する。 量子化形式が書かれていないベンチマークは、そもそも判断材料になりません。
数十万円の買い物の判断材料にする前に、割り算ひとつで確かめられます。
🛠️ 実効率はランタイムでも変わる
同じ機体でも、何で動かすかで実効率は上下します。Apple Silicon前提なら、選択肢は実質2系統です。
- llama.cpp系(Ollama・LM Studioを含む): GGUF形式が使え、モデルの入手性が最も高い。OllamaとLM Studioはバックエンドが同じなので速度もほぼ同等
- MLX(Apple製フレームワーク): ユニファイドメモリ前提で設計されており、同じ量子化・同じ機体でllama.cpp比で有利という報告が多い
この記事の概算はllama.cpp系の実測から逆算した実効率43〜80%を使っています。MLXならレンジの上側に寄る可能性がありますが、新型4チップでの実測が存在しない以上、上振れ分は見込まずに計算しました。
⚠️ この式が使えない3つの場面
- プロンプト処理(prefill): 帯域ではなく演算能力で決まります。ここはApple Siliconの弱点で、長文入力やコーディングエージェント用途では生成速度より効いてきます
- MoEモデル: 毎回すべての重みを読まないため、総サイズを分母にすると大きく外します
- 長い会話履歴: 70Bクラス(80層・KVヘッド8・head_dim 128・fp16)は1,000トークンあたり約0.33GBのキャッシュを食うので、32Kトークンで約10.7GB増え、上限が2割ほど落ちます
私の用途(コーディングエージェント)ではprefillが効くと見ています。 だから70Bは常用に据えず、長文を読ませる作業は引き続きクラウドAPIに任せる前提で買いました。実機到着後にprefill速度も実測します。
📊 64GBのMac Studioで実際に何が動くのか【概算】
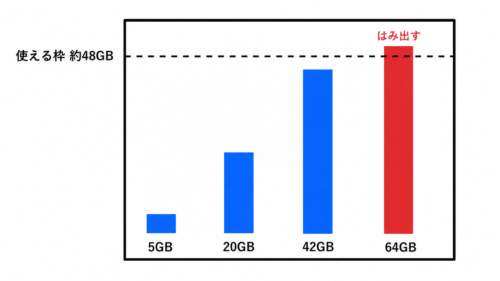
64GB(GPUに割り当てられる枠は約48GBと見込んでいます)なら、70Bクラスまで載ります。 ただし速度は控えめです。
[!important] 📌 この章の数値はすべて概算です
新型4チップの実測値は、執筆時点で世界のどこにも存在しません(発売が2026年9月22日のため)。以下は614GB/s・実効43〜80%から計算した推定です。
48GBという枠自体も推定値です。 macOSがGPUに回す量はOSが確保する固定ぶんを差し引いた残りなので、総容量が大きい機種ほど割当比率は上がります(32GB機は21〜25GB=約70%、64GB機はおおむね75%前後)。ここも実機で測り直します。
📏 容量別に何が動くか
| 搭載メモリ | GPU割当の目安 | 実用上の上限モデル(Q4) |
|---|---|---|
| 16GB | 約11GB | 8Bクラスまで |
| 24GB | 約17GB | 14Bクラスまで |
| 32GB(M6上限・現用M1 Max) | 約21〜25GB | 32Bクラスまで |
| 64GB(今回の2機種) | 約48GB | 70Bクラスまで |
| 128GB(M5 Max上限) | 約96GB | 70B Q8/120BクラスMoE Q4 |
| 256GB以上(M5 Ultra) | 約192GB〜 | 200B超クラス Q4 |
📋 モデル別の概算表と、実用ライン
| モデル | 重みサイズ | 生成速度の概算(614GB/s) | 期待値(65%) |
|---|---|---|---|
| 8Bクラス Q4 | 4.9GB | 54〜100 tok/s | 81 |
| 14Bクラス Q4 | 9GB | 29〜55 tok/s | 44 |
| 32Bクラス Q4 | 20GB | 13〜25 tok/s | 20 |
| 32Bクラス Q8 | 35GB | 8〜14 tok/s | 11 |
| 70Bクラス Q4 | 42.5GB | 6.2〜11.6 tok/s | 9.4 |
| 120BクラスのMoE | 約64GB | 載らない | — |
tok/s は「1秒あたりに出力される文字のかたまりの数」です。 人が文章を黙読する速度がおよそ10〜15 tok/s なので、10 tok/s を超えると「読んでいる間に次が出てくる」体感になります。
この基準で言うと、私の判定はこうです。
- 32Bクラス Q4(13〜25 tok/s)=常用ライン。待ち時間を意識せず使えます
- 70Bクラス Q4(6.2〜11.6 tok/s)=切り替えて使うライン。チャットで読みながら待てますが、コードを一気に書かせるにはもどかしい速度です
つまり653,800円で買えるのは「70Bを常用する環境」ではなく、「精度が要る場面だけ70Bに切り替えられる環境」です。 常用は32Bクラスになります。
なお70Bクラスを載せると、48GB枠のうち残りは約5.5GBです。キャッシュは1,000トークンあたり約0.33GBなので、持てる会話履歴はおよそ1.6万トークン(日本語で1万字前後)が上限になります。長いコードベースを丸ごと読ませる使い方には足りません。
🔑 32GB→64GBで変わるのは「速さ」ではなく「載ること」
ここがこの記事でいちばん伝えたい部分です。
| 機種 | 帯域 | GPU割当枠 | 70B Q4(42.5GB) | 生成速度の概算 |
|---|---|---|---|---|
| MacBook Pro M1 Max 32GB(現用) | 400GB/s | 約21〜25GB | ✕ 載らない | — |
| Mac mini M5 Pro 64GB | 307GB/s | 約48GB | ○ | 3.1〜5.8 tok/s |
| Mac Studio M5 Max 64GB | 614GB/s | 約48GB | ○ | 6.2〜11.6 tok/s |
注目してほしいのは1行目です。現用のM1 Maxは帯域400GB/sで、Mac mini M5 Pro(307GB/s)より速いのに、70Bクラスは実行すらできません。 枠に載らないからです。
容量が足りないと、帯域の速さは無意味になります。
そして32GBから64GBへの乗り換えで得られる実利は、「速くなること」ではありません。帯域は400→614GB/sで1.53倍にとどまります。得られるのは「今まで物理的に動かせなかったモデルが動くようになる」という、連続的ではない変化のほうです。
🔍 Mac Studio M5 Ultra と「他の選択肢」を外した理由
先に結論を書きます。24GB級のGPUをすでに持っているなら、この買い物は不要かもしれません。 M5 Ultraは予算で、整備済のM3 Ultraは在庫の読めなさで外しましたが、いちばん強い対抗馬は「手持ちのRTX 3090」でした。順に説明します。
🧩 その前に:M5 Max 128GB(941,800円)を検討した
419,800円+54,000円(40コアGPU)+414,000円(36→128GB)+54,000円(1TB)で941,800円。M5 Ultraの最小構成より8,000円安く、GPU割当枠は約96GBに広がります。
70B Q8や120BクラスのMoEが載る一方、帯域は614GB/sのままなので70B Q4の生成速度は64GB構成と変わりません。つまり「載る範囲を広げるために288,000円を追加で払うか」という問いになります。私は今回動かしたいのが70B Q4までだったので見送りました。128B超を常用する人にとっては、M5 Ultraより先に検討すべき構成です。
💸 M5 Ultra(949,800円〜)は予算オーバーだった
M5 Ultraは帯域1.2TB/s、メモリ最大512GBという圧倒的な性能です。それでも価格で落選しました。
ここで注意点があります。949,800円という価格は、30コアCPU/64コアGPU/96GB/1TBという標準構成の値段です。 36コアCPU/80コアGPUにすると1,183,800円(+234,000円)まで上がり、512GBメモリはこの構成が必須で発売も10月下旬です。「949,800円で最上位が買える」と誤解すると、23万円読み違えます。
🖥️ 整備済製品・前世代機・手持ちのGPU
ここは自分に不利なことも書きます。
私は「帯域と容量で機種を選ぶ」という基準を立てました。その基準を一貫させるなら、新品4機種の中だけで比べるのは筋が通りません。
- 整備済のMac Studio M3 Ultra 96GBは帯域819GB/sで、M5 Max 64GB(614GB/s)を33%上回ります。容量も1.5倍です。ただしこれは生成速度側の話に限られます。 AppleはM5 MaxのLLMプロンプト処理をM4 Max比3.9倍としており、M5世代は前節で「Apple Siliconの弱点」と書いたprefillを直接強化した世代です。M3 Ultraにこの機構はありません。長文を読ませる用途なら帯域33%の差は逆転しうる——というのが私の見立てで、ここは実測が出るまで判定できません
- 整備済のM4 Max 64GBも546GB/sで、614GB/sの89%に達します
新品を選んだのは、保証期間の長さと在庫の安定性を取ったからです。整備済製品は狙った構成が出てくるとは限りません。
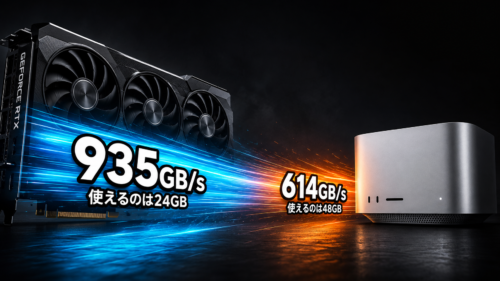
さらに正直に書くと、私はRTX 3090でローカルLLMを運用しています。
| 機種 | 帯域 | 使える容量 | 追加費用 |
|---|---|---|---|
| RTX 3090(所有済み) | 936.2GB/s | 24GB(実際に使えるのは23GB前後) | 0円 |
| Mac Studio M5 Max 64GB | 614GB/s | 約48GB | 653,800円 |
8B・14Bクラスの4bit量子化なら、手持ちのRTX 3090のほうが速く、追加費用は0円です。 32Bクラス Q4(約20GB)も載りますが、残り3GB前後でキャッシュを賄うことになるので、長い会話履歴や長文入力を伴う使い方では窮屈になります。Mac側に「64GB中48GBまで」という枠を当てはめた以上、GPU側にも同じ目線を当てるべきなので、ここは正直に書いておきます。
653,800円を払って買えるのは「24GBに収まらないモデルを動かせること」であって、「32Bクラスが速くなること」ではありません。
もうひとつ、Apple Siliconには外付けGPUという逃げ道がありません。メモリも増設できないので、買った時点で上限が確定します。
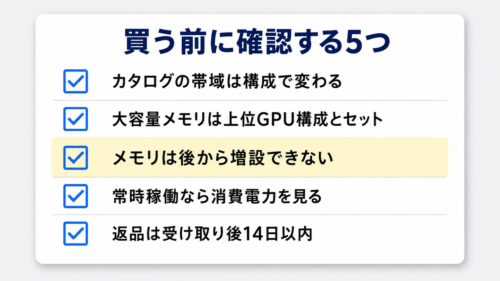
❓ 買う前によくある質問と、5つの落とし穴
まず出荷スケジュールです。
| 機種・構成 | 出荷開始 |
|---|---|
| Mac mini(M6 / M5 Pro) | 2026年9月22日 |
| Mac Studio(M5 Max / M5 Ultra) | 2026年9月22日 |
| Mac Studio M5 Ultra 512GBメモリ構成 | 2026年10月下旬 |
Q. カタログの「614GB/s」はどの構成でも出ますか?
出ません。614GB/sは40コアGPU構成の値で、標準の32コアGPU構成(419,800円)は460GB/sです(Apple公式のMac Studio技術仕様)。M6も16GB構成では153GB/sで、170GB/sは出ません。
Q. Mac Studioで48GB以上を選ぶと何が起きますか?
40コアGPUが強制され、+54,000円が必ず乗ります(標準の32コアGPU構成では36GBまで)。一方、Mac mini M5 Proにはこの縛りがなく、標準の15コアCPU/16コアGPUのままでも64GBを選べます。
Q. メモリは後から増設できますか?
できません。ユニファイドメモリは基板に直付けで、外付けGPUという逃げ道もありません。買った時点で上限が確定します。
Q. 24時間つけっぱなしにするならどちらですか?
Mac miniです。 最大消費電力はMac mini 155W、Mac Studio 480Wで、電気代と発熱に直結します。
Q. 買って合わなかった場合、返品できますか?
受け取り後14日以内なら返品でき、出荷前ならキャンセルもできます。 実機で測って合わなければ戻せるので、判断を先送りにせず注文して確かめるという選択もあります。

📝 まとめ
🧭 あなたはどれを買うべきか(3つの質問)
質問1:動かしたいモデルは24GBに収まりますか?(8B・14B・32BクラスのQ4なら収まります)
→ はい:24GB級のGPUを持っているなら、それで十分です。買わないのが正解。持っていないなら質問2へ。
質問2:70Bクラスを動かしたいですか?
→ いいえ:M6の32GBで足ります。149,800円〜のM6 Mac miniが第一候補です。クラウドAPI主体の開発なら、なおさらこれで十分です。
→ はい:質問3へ。
質問3:予算は65万円まで出せますか?
→ はい:Mac Studio M5 Max 64GB(653,800円)。この記事の結論です。
→ いいえ(55万円まで):Mac mini M5 Pro 64GB(551,800円)。70Bは載りますが3.1〜5.8 tok/sなので、待てる速度かどうかを事前に見極めてください。
→ 128B超も動かしたい:M5 Max 128GB(941,800円)がM5 Ultraより先の候補です。
要点
- 💰 同じ64GB・1TBに揃えると価格差は66,000円(CPU/GPUのコア数も揃えた場合。64GBを最も安く積むなら差は102,000〜120,000円)
- ⚡ その66,000円でメモリ帯域とGPUコアが揃って2.00倍(307→614GB/s、20→40コア)
- 🚫 ローカルLLM目的ならM6は選択肢に入らない(メモリ32GB上限が、AI性能最大4倍という進化を打ち消す)
- 🔑 32GB→64GBの実利は「速さ」ではなく「載ること」(帯域は1.53倍だが、動かせるモデルの範囲が変わる)
- 🧮 ベンチ数値は「帯域÷モデルサイズ」で検算できる(実効率43〜80%を超えていたら、測定条件を確認する)
私の場合は「70Bクラスを動かしたい」という条件があったので、653,800円のMac Studioを選びました。実機の到着は2026年9月22日です。到着後に実測を取り、この記事の概算がどれだけ当たっていたかを検証する予定です。
👉 Apple公式サイトでMac Studioの構成を組んでみる
👉 Apple公式サイトでMac miniの構成を組んでみる
📚 Mac選びとAI駆動開発の関連記事
- MacBook Neo 8GB最小構成でAI駆動開発は可能?実機で本気検証した結果 — 99,800円の最小構成で10日間検証しました。今回の653,800円とは価格帯の正反対です
- プログラミング未経験OK!XcodeとClaudeでiPhoneゲームを作る全手順 — クラウドAPI主体のAI駆動開発なら、そもそも高いマシンは要りません
コメント